Articles · Jean Silga
Comment j’ai construit une plateforme cloud native en partant de zéro
Quatre serveurs loués, un cluster Kubernetes en moins d’une heure, puis le reste de la plateforme, un chart Helm après l’autre.
Si vous avez lu mon article précédent, « Mon parcours pour maîtriser Kubernetes et le cloud native », vous savez déjà que j’ai décidé de construire une vraie plateforme cloud native en partant de zéro avant de passer l’examen CNPE. Cette décision relevait peut-être de la procrastination dans ce qu’elle a de plus raffiné : se fixer un objectif démesuré comme condition préalable, pour être bien sûr de ne jamais l’atteindre…
Bref, j’ai décidé de construire de zéro une plateforme cloud native complète. Voici comment ça s’est passé.
J’ai commencé par louer deux serveurs privés virtuels (VPS) chez Contabo, un hébergeur cloud allemand. Comment l’ai-je choisi ? J’ai demandé conseil à une IA. Elle m’a fait cinq propositions, et Contabo arrivait en deuxième. Je suis allé sur leur site. Les prix étaient affichés clairement, les services bien expliqués, la commande simple. Je les ai retenus et je suis passé à la suite.
J’ai pris deux VPS pour commencer : l’un avec un disque NVMe pour le control plane, l’autre avec un SSD pour le nœud worker. En quelques minutes, les deux tournaient, joignables et prêts à l’emploi. Un achat agréable.
J’ai ensuite préparé le control plane pour installer Kubernetes. J’ai créé un compte d’administration dédié sur chaque nœud et déposé mes clés SSH pour me connecter sans mot de passe. J’ai suivi la documentation officielle de Kubernetes et scripté tous les prérequis dans un fichier Bash. Puis j’ai écrit un playbook Ansible pour exécuter ce script sur le control plane.
Vient le grand moment : kubeadm init.
Quelques minutes plus tard, j’avais devant moi un control plane Kubernetes qui attendait qu’un CNI soit prêt. J’ai installé Calico, et le control plane est passé à l’état prêt, dans l’attente de son premier nœud worker.
J’ai foncé. J’ai appliqué au nœud worker une version légèrement modifiée du script de mon playbook d’initialisation (pas besoin de kubectl sur un worker, par exemple). Puis j’ai lancé la commande kubeadm join. Il a fallu quelques minutes au worker pour s’initialiser et rejoindre le control plane. Et il l’a fait.
J’avais maintenant sous les yeux un cluster Kubernetes qui fonctionnait : un control plane et un nœud worker. Ça faisait du bien. Entre la location des machines et le cluster opérationnel, il s’était écoulé moins d’une heure.
Avant mon parcours de certifications Kubernetes de la CNCF, je n’aurais même pas eu le courage d’essayer. Je me suis surpris moi-même. Les connaissances acquises pendant ce parcours, et la confiance qu’elles m’avaient donnée, commençaient à se faire sentir là où je ne les attendais pas. Et ce n’était que le début.
J’ai démoli et reconstruit le cluster bien des fois, le temps de mettre au point le script Bash qui initialisait les nœuds. J’avais par exemple oublié de donner un nom d’hôte personnalisé aux nœuds, et je ne m’en suis aperçu qu’une fois le cluster en marche. Changer le nom d’hôte d’un nœud control plane en service peut être risqué. Comme je débutais, j’ai préféré la prudence : j’ai réinitialisé la VM et tout recommencé. Tout étant scripté, j’étais reparti en quelques minutes.
Souvenez-vous : mon but était de monter une plateforme cloud native complète. Le cluster Kubernetes n’en était que la première brique, les fondations. Et comme toutes les fondations, il fallait les poser avant le reste. Je pouvais désormais installer les autres briques, chacune avec un chart Helm. Voici la plateforme complète, telle que la décrit cet article.
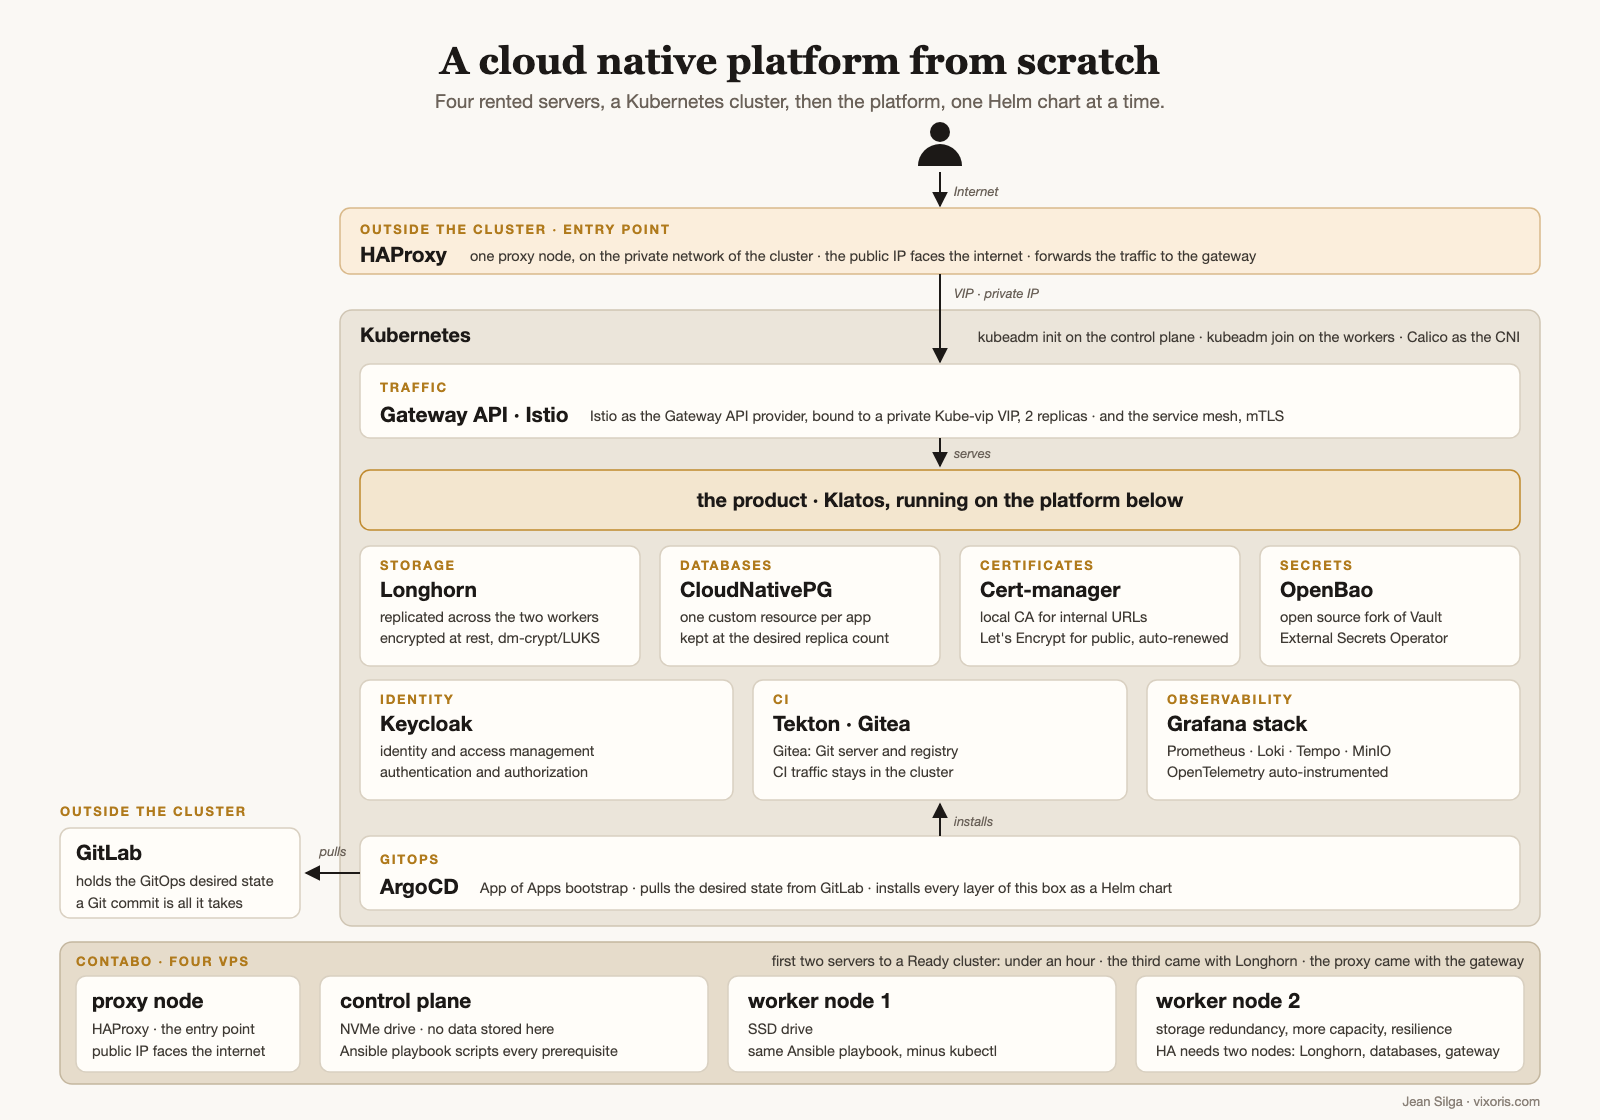
Première étape une fois Kubernetes en place : un outil GitOps. Certifié Argo Project Associate, je me suis naturellement tourné vers ArgoCD. J’ai créé dans GitLab la structure du dépôt Git destiné aux manifestes de mes Argo Apps, puis un deploy token pour qu’ArgoCD puisse s’authentifier, puis un secret Kubernetes contenant ce jeton, pour qu’ArgoCD parle à GitLab de lui-même. J’ai installé ArgoCD depuis son chart Helm et écrit le fichier par lequel passe chaque installation ultérieure sur le cluster : le bootstrap App of Apps. Ce fichier, c’est la graine. Depuis, il suffit d’un commit Git pour qu’ArgoCD prenne quelque chose en charge et l’installe dans le cluster.
Dès qu’on dépasse le stade du hello world, un cluster Kubernetes a besoin d’un outil de virtualisation du stockage. Les volumes de base hostPath et emptyDir ne conviennent pas à un vrai usage. J’ai retenu Longhorn comme orchestrateur de stockage. Pas de virtualisation du stockage sérieuse sans redondance : il me fallait donc au moins un second nœud worker pour faire la paire avec le premier. Je ne voulais en aucun cas que le control plane stocke des données. Et un second worker apporterait aussi de la capacité et de la résilience, et rendrait la haute disponibilité possible.
Dans l’ensemble, Longhorn s’est révélé simple à mettre en place, avec un excellent rapport bénéfice/complexité. J’ai aussi activé le chiffrement au repos. Longhorn chiffre au niveau du volume avec dm-crypt/LUKS de Linux, et c’est moi qui détiens la clé.
Pour les bases de données, j’ai choisi l’opérateur CloudNativePG. Il m’a permis de créer sans effort une base pour chaque application déployée. Il me suffisait de créer une ressource personnalisée avec les paramètres de la nouvelle base, et l’opérateur s’occupait de tout : créer la base, la maintenir en service, tenir le nombre de réplicas voulu.
Restait à choisir comment exposer les services. J’ai opté pour Gateway API plutôt qu’Ingress, avec Istio comme implémentation. Je voulais déjà Istio comme service mesh, surtout pour le mTLS ; m’en servir aussi pour Gateway API était un bonus. Et la mise en place a été simple.
Question suivante : quelle adresse IP la passerelle allait-elle utiliser ? Prendre l’IP statique d’un nœud était exclu, pour deux raisons. D’abord, la passerelle tomberait avec le nœud. Ensuite, je ne voulais exposer l’adresse IP publique d’aucun nœud du cluster. J’ai conçu une solution en deux temps. D’abord, avec l’utilitaire Kube-vip, j’ai mis en place une adresse IP virtuelle (VIP) privée, qui peut passer dynamiquement d’un nœud du cluster à l’autre. Ainsi, la VIP reste disponible tant qu’il reste un nœud sain dans le cluster. J’ai attribué cette VIP à la passerelle. Ensuite, j’ai installé hors du cluster un nœud proxy qui sert de point d’entrée. Ce nœud tourne sous HAProxy et fait partie du réseau privé du cluster. Il reçoit le trafic venu d’internet et le transmet à la passerelle par la VIP.
Puis la gestion des certificats. Cert-manager s’imposait, et je l’ai pris. Je m’en suis d’abord servi pour créer une autorité de certification locale pour mes URL internes. Le second usage était plus intéressant : je l’ai relié à Let’s Encrypt, et des certificats valides pour mes URL publiques sont désormais générés à la volée. Le renouvellement est automatique, lui aussi. Il m’a fallu plusieurs essais, mais ça a fini par marcher.
Il me fallait ensuite un coffre-fort pour les secrets. J’ai envisagé HashiCorp Vault, avant de retenir OpenBao, un fork open source né quand HashiCorp a changé sa licence. Pour faire passer les secrets d’OpenBao au cluster Kubernetes, j’ai utilisé l’External Secrets Operator.
Au tour de l’intégration continue. La CNCF met Tekton en avant pour cela, alors je l’ai essayé. L’outil est complexe à mettre en place, et j’ai d’abord eu du mal. Rien que pour comprendre combien de composants compte Tekton et à quoi sert chacun, il m’a fallu du temps. J’ai fini par le faire tourner, et plus tard je me suis félicité d’avoir persévéré : ça en valait la peine. Restait à le brancher sur un dépôt de code source pour le tester.
C’est là que je me suis dit : Tekton tourne entièrement dans le cluster Kubernetes. Il peut récupérer du code dans n’importe quel dépôt Git et pousser des artefacts vers n’importe quel registre. Et s’il récupérait le code à l’intérieur du cluster, et poussait les artefacts vers un registre lui aussi dans le cluster ? Tout le trafic de la CI resterait à l’intérieur.
J’ai cherché, et Gitea convenait bien : c’est à la fois un serveur Git et un registre de conteneurs, il est cloud native et sobre en ressources. Va pour Gitea.
Venait ensuite la gestion des identités et des accès : comment gérer l’authentification et les autorisations. Celle-là était facile. Je travaille avec Keycloak depuis 2019. Pas de débat.
L’observabilité figurait aussi sur ma liste. Je voulais savoir à tout moment ce qui se passait dans tout ce que je déployais, ce que vivaient les utilisateurs, et pouvoir enquêter vite en cas de problème. J’ai retenu les trois types de télémétrie : logs, métriques et traces. J’ai opté pour la stack Grafana complète, et instrumenté mes apps avec l’auto-instrumentation OpenTelemetry pour obtenir les traces. Prometheus stocke les métriques. Loki et Tempo servent de backends aux logs et aux traces, avec MinIO comme stockage derrière les deux.
Voilà pour l’essentiel. Une sacrée aventure, instructive et plaisante. Il y a un an, je n’aurais pas eu le courage de me lancer dans un tel projet parallèle. Une seule chose l’a rendu possible : la confiance acquise avec les certifications CNCF.
Une fois une telle plateforme construite, on cherche naturellement quelque chose à déployer dessus. Comme je l’écrivais la dernière fois, j’ai passé trois mois sans mission au début de 2026. Pour garder une trace de l’emploi de mes journées, j’avais créé un fichier Excel avec une liste d’habitudes quotidiennes à tenir : sport, apprentissage utile, sobriété numérique, heures de coucher et de lever, journal, marche dehors, méditation, etc. Je l’avais commencé pour avoir un relevé exact de mes journées, plutôt que de me fier à mon impression.
Plus tard, pendant que je construisais ma plateforme, une idée a commencé à germer : et si je transformais ce fichier Excel en vraie app, déployée sur ma plateforme et ouverte à tous ? L’idée tenait assez la route pour que je décide de tenter le coup. De toute façon, j’avais envie de construire une app depuis un moment.
Jusque-là, je m’abritais derrière deux excuses : construire coûtait cher, et je ne trouvais pas d’idée qui en vaille la peine. Ces deux excuses ne tenaient plus, pour deux raisons. L’IA avait nettement fait baisser le coût de construction. Et j’avais plus qu’une idée : quelque chose de concret, un fichier Excel dont je me servais chaque jour, et dont je savais qu’il en valait la peine.
Et une motivation de plus, la cerise sur le gâteau : une plateforme cloud native complète, toute neuve, prête à héberger l’app.
La suite est une autre histoire.
Mise à jour du 20 septembre 2026. J’ai depuis publié la configuration de cette plateforme dans un dépôt public. C’est un instantané épuré du dépôt GitOps à partir duquel ArgoCD déploie : le bootstrap App of Apps, les valeurs Helm de chaque composant, les playbooks Ansible et les scripts kubeadm, tout au même endroit. Chaque secret, nom d’hôte et adresse IP y est remplacé par une valeur fictive : c’est une référence à lire et à adapter, pas une distribution à déployer telle quelle. Si vous préférez voir comment les pièces s’assemblent plutôt que de le lire : https://gitlab.com/jeansilga-public/cloud-native-platform
Cette app, c’est Klatos : une app d’habitudes où les petits gestes de chaque jour finissent par changer une année. Elle tourne sur la plateforme décrite ici, et c’est le premier produit de Vixoris.
Découvrir Klatos →